先把结论放前面:多账号运营里说的"缓存隔离",标准做法是给每个账号分配一个独立的浏览器用户数据目录,让它们各自拥有自己的 Cookies 数据库、HTTP 磁盘缓存、LocalStorage、IndexedDB 和网络栈。不是开无痕窗口,也不是登完一个账号清一次缓存——这两种做法都留有缺口,而且缺口的位置不在你平时能看见的地方。
下面按你实际要做的顺序走:先搞清楚到底要隔什么,再说为什么常见做法不够,然后是怎么配、怎么验证、换机怎么办。
要隔离的不止是 Cookie
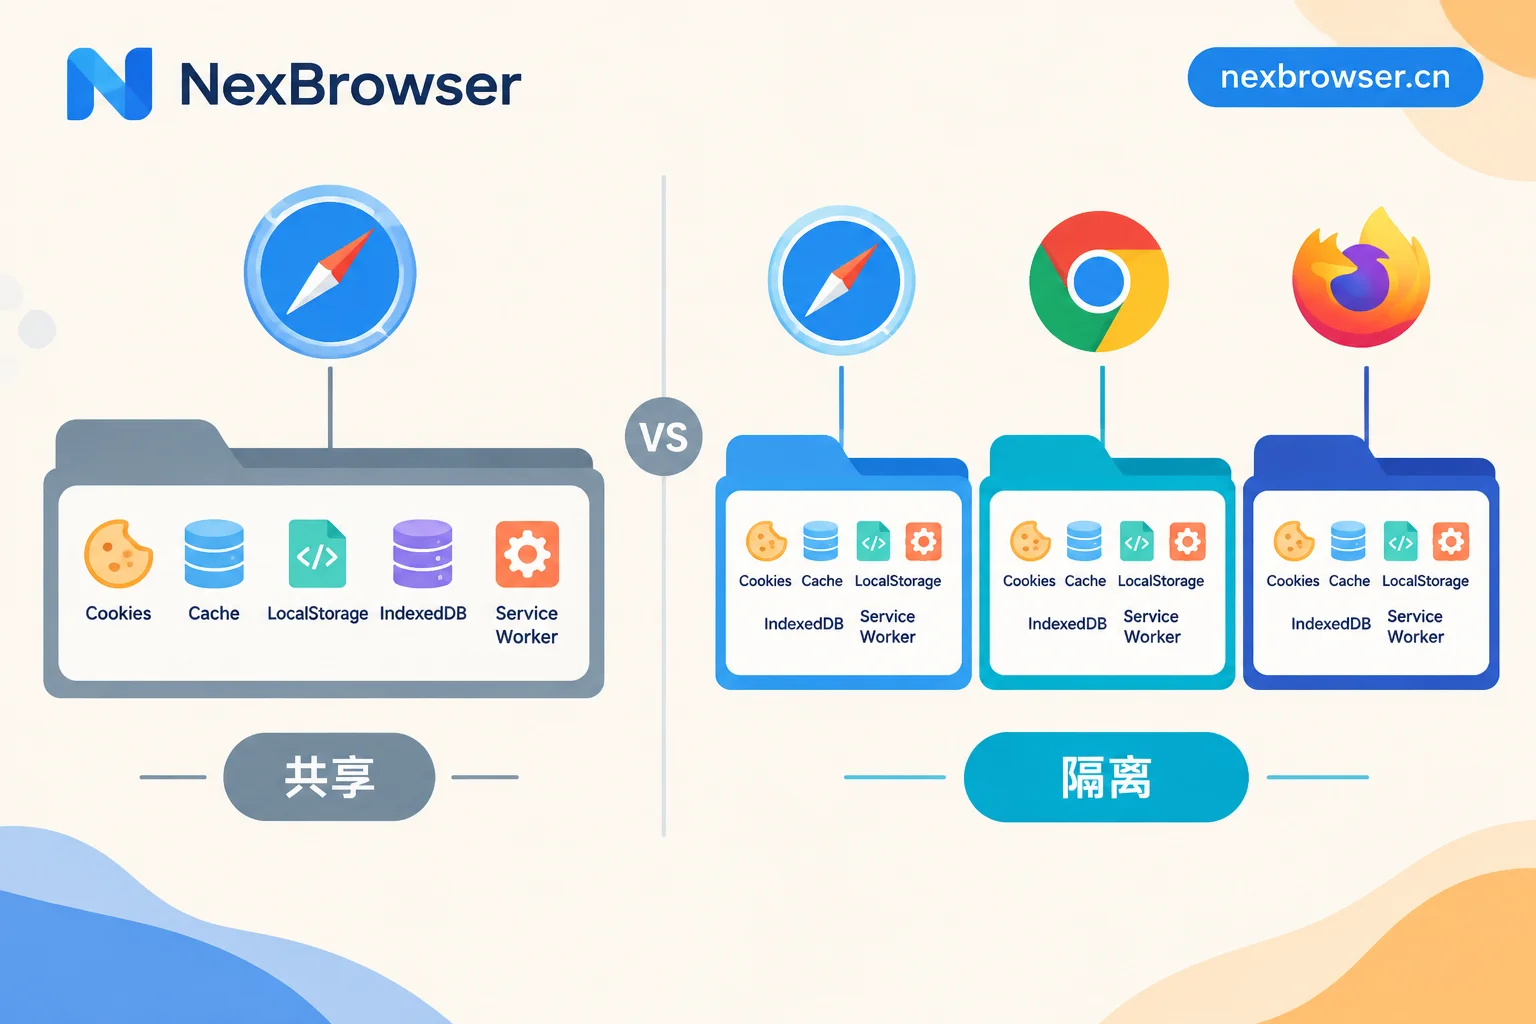
很多人把"清缓存"理解成浏览器设置里那个"清除浏览数据"按钮。但浏览器在你访问一个站点时落到磁盘上的东西,比那个面板里列出的条目要多:
- Cookies:会话凭证,最常被提到,也最容易被清掉
- HTTP 磁盘缓存(Disk Cache):静态资源的本地副本,带有 ETag 等校验标记
- Code Cache / GPU Cache:编译过的 JS 字节码缓存、图形资源缓存
- LocalStorage 与 SessionStorage:站点自己写入的键值对,前者长期留存
- IndexedDB:结构化数据库,平台常用来存草稿、离线数据、设备标识一类的东西
- Service Worker 注册信息与其缓存:一个注册过的 Service Worker 会把自己的缓存留在磁盘上,即使你关了页面它也还在
这些数据里,任何一项只要在两个账号之间共用,站点就有机会把它们对应到同一台设备上。真正麻烦的是后面几项:Cookie 好清,IndexedDB 和 Service Worker 缓存则很容易在手动清理时被漏掉。你以为清干净了,实际上某个平台早在你第一次登录时就往 IndexedDB 里写了一条标识,后面换了账号它还在那儿。
所以"缓存隔离"这个说法,准确的意思是:把上面这一整套本地存储加上网络连接状态,按环境切开,各存各的。
隐身模式为什么替代不了环境隔离
无痕窗口是最常被误用的方案,有两个硬伤。
第一,同一个浏览器实例下的多个无痕窗口不是相互隔离的。 它们共享同一个内存级的 Cookie Jar,也共享底层的网络连接池和 DNS 缓存。你开两个无痕窗口分别登两个账号,在浏览器看来这就是同一个会话上下文里的两件事——这不是配置问题,是 Chromium 的设计如此。
第二,无痕模式关闭即清空,这恰恰和运营需求相反。 日常运营需要的是长期保持登录态:今天登上去,明天打开还在,Cookie 和 LocalStorage 里的偏好设置都在。无痕窗口一关全没了,你每次都要重新登录、重新过验证,反而制造了更多异常信号。
手动清缓存的问题上面说过了:清理粒度对不上。浏览器的清除面板是按数据类型和时间范围来的,不是按账号来的,你没法只清"账号 A 留下的那部分",而全清又会把另一个账号的登录态一起带走。
Chromium 的缓存分区管的是另一件事
这一点容易被误解。现代 Chromium 内核确实引入了 HTTP 缓存分区和网络状态分区(双键/三键缓存),做法是把缓存条目的键从单纯的资源 URL,改成"顶级站点 + 资源 URL"的组合。
但它解决的问题是第三方跨站追踪:当 a.com 和 b.com 都嵌入了同一个 CDN 上的脚本时,这个脚本在两边被分别缓存,b.com 没法通过缓存命中时间来判断你之前访问过 a.com。
注意分区的键是顶级站点。也就是说,你在同一个浏览器里开两个标签页访问同一个电商平台,顶级站点相同,分区键也相同,两个标签页读写的是同一份缓存和同一份本地存储。浏览器自带的分区机制在这里完全不起作用——它本来也不是为这个场景设计的。
把这条记住就够了:缓存分区防的是跨站,多账号需要的是同站内的切分,两者不重叠。
正确做法:一个环境一个用户数据目录
Chromium 层面真正能做到彻底隔离的机制,是启动时用 --user-data-dir 指定独立的用户数据目录。指定之后,这个实例会在该路径下初始化属于自己的一套东西:Cache 文件夹、Cookies 的 SQLite 数据库、IndexedDB 目录树、Local Storage 目录,以及独立的网络事务处理链路。
不同目录之间是文件系统级别的分开,不存在"漏过去"的可能性——除非你自己手动去复制文件。这是所有指纹浏览器做环境隔离的底层依据,区别只在于外层怎么管理这些目录、怎么把指纹参数和代理绑上去。
落到操作上,你要做的是三件事按顺序来:
- 建环境:一个账号建一个环境,不要在同一个环境里登两个同平台账号。环境创建时会生成自己的存储目录和一组自洽的指纹参数。
- 绑代理:环境建好后立刻把出口 IP 绑上,打开前先做一次连通性检测,确认出口国家/地区和你这个账号的常用地相符。存储隔离和网络出口是两件事,缺一个都不完整。
- 命名分组:用"平台-账号标识-用途"这种格式命名,账号多了以后靠分组找,不靠记忆。
NexBrowser 的环境隔离与分组就是按这个逻辑组织的:新建环境即自动生成独立的隔离目录与自洽指纹,代理可以在环境上直接绑定并检测,环境按分组管理。免费档功能不设限、额度不过期,付费只加窗口和成员容量,先建几个环境把流程跑通再考虑扩容就行。
三步验证隔离真的生效
配完不要默认它生效了,花两分钟验一下。下面三步从浅到深。
第一步,看 Application 面板。 同时打开两个环境,各自访问同一个目标平台,按 F12 打开开发者工具,切到 Application(应用)面板。左侧 Storage 下面依次展开 Cookies、Local storage、IndexedDB,逐项对照两个环境的内容。如果隔离生效,Cookie 表里的会话值应该完全不同,LocalStorage 的键值也各自独立。
第二步,做一次写入读取测试。 这步比肉眼对照可靠。在环境 A 打开目标站点的页面,在 Console 里执行:
localStorage.setItem('isolation_test', 'env_A')然后切到环境 B,打开同一个域名下的页面(这点必须注意,LocalStorage 是按源划分的,不同域名下查不到东西,那样测出来的 null 没有意义),在 Console 里执行:
localStorage.getItem('isolation_test')返回 null 说明两个环境的本地存储互不可见。如果返回了 env_A,说明这两个窗口实际上跑在同一个数据目录里,得回去检查环境是怎么建的。
第三步,验网络出口。 在两个环境里分别访问一个显示当前 IP 的页面,确认出口地址不同,且和你给各自绑定的代理一致。存储隔离做好了但出口 IP 撞一起,仍然是同一台设备的信号。
这三步过了,基本可以认为环境级隔离是落地的。关于四层边界(存储、指纹、网络、行为)各自该查什么,可以再看浏览器环境隔离到底隔离了什么。
换机同步:什么会跟着走,什么不会
换电脑或者多人协作时,最担心的是登录态丢失。指纹浏览器的云端同步一般采取这样的取舍:同步核心凭证与环境配置,不同步体积庞大的静态缓存。
具体说,Cookie、LocalStorage 里的登录相关数据、指纹参数、代理配置这些会跟着云端走;而 HTTP 磁盘缓存里的图片、脚本副本留在原机器上,新机器首次打开时重新拉取。这样做的原因有两个:一是静态缓存动辄几百 MB 起,几十个环境同步一遍带宽和存储都吃不消;二是这些资源本来就是可重建的,重新下载不影响登录态。
所以换机后的表现通常是:打开环境还是登录状态,但页面首次加载会慢一点,属正常。真正需要你在换机后复核的是代理绑定和出口 IP——新机器的网络环境变了,绑定的代理是否仍然可用、出口是否还在原来的地区,要重新检测一遍。完整的迁移顺序可以参考浏览器环境迁移怎么做。
至于"只清某个环境的 HTTP 缓存但保留 Cookie"这类细粒度操作,不同客户端的支持程度和入口位置差别较大,以你手上客户端当前版本的界面说明为准,不要凭经验猜路径。
几个容易让隔离失效的动作
- 在一个环境里登多个同平台账号。环境目录是隔开了,但目录内部是共享的,同环境两个账号完全等同于同一台设备上的两个账号。
- 复制环境后直接用。有些工具支持复制环境,复制出来的副本可能连带存储数据一起复制,等于人为制造了两个带相同痕迹的环境。复制后至少要清一次存储,或者干脆新建。
- 跨环境粘贴登录信息时顺手同步了浏览器账号。在环境里登录 Google/Edge 的浏览器同步账号,会把书签、密码甚至部分站点数据串到云端,绕过你辛苦做的本地隔离。
- 代理换了但环境没动。IP 变了而本地存储里还留着老的痕迹,两边对不上也是一类异常信号。
更多常见的失效动作可以对照浏览器多开防关联怎么做自查一遍。
最后提醒一句边界:环境隔离是管理你自有账号的技术手段,能做到的是让不同账号的本地痕迹互不交叉,不等于任何形式的安全承诺。账号本身的合规、平台规则的遵守,是另一码事。
要开始动手的话,从建第一个环境跑通上面的验证三步开始:下载 Windows 客户端(国内和海外两条线路,安装包带代码签名,安装前核对一下签名信息),建环境、绑代理、F12 验一遍,前后不超过十分钟。


评论(0)